AWSの運用で効いてくるのは、派手なテクニックではなく「あとから変えるのが高いもの」を最初に決めたかどうかです。
この記事では、運用でつまずきやすい項目を「後から変えるコストが高い順」に並べて整理します。上から順に潰していけば、あとで作り直しになる範囲が小さくなります。
変えるコストが高い順に並べる
| 決めること | あとから変えると | 優先度 |
|---|---|---|
| アカウントの分け方 | リソースの引っ越しになる | 最優先 |
| VPCのCIDR | 作り直しになる | 最優先 |
| 人の認証の入口 | 全員の再設定が必要 | 高 |
| ログと証跡の集約先 | 過去の記録は戻せない | 高 |
| タグの設計 | 既存リソースへの一括付与が要る | 中 |
| アラートのしきい値 | いつでも直せる | 低 |
下の2つは、運用しながら調整すればいい項目です。時間をかけるべきは上の4つで、ここを飛ばすと後で必ず高くつきます。
VPCのCIDRについては別の記事に書いたので、ここでは残りを扱います。
1. アカウントを分ける
1つのアカウントに本番も開発も同居させると、次の問題が全部まとめて来ます。
- 権限を分けられない
「開発環境だけ触れる」をIAMポリシーで表現するのは、リソース単位の条件を積み上げる作業になります - コストを分けられない
タグで分類するしかなく、タグの付け忘れがそのまま集計漏れになります - 事故が波及する
開発環境のつもりで実行したコマンドが本番に当たります - サービスの上限を共有する
開発でLambdaを大量に起動すると、本番がスロットリングされます
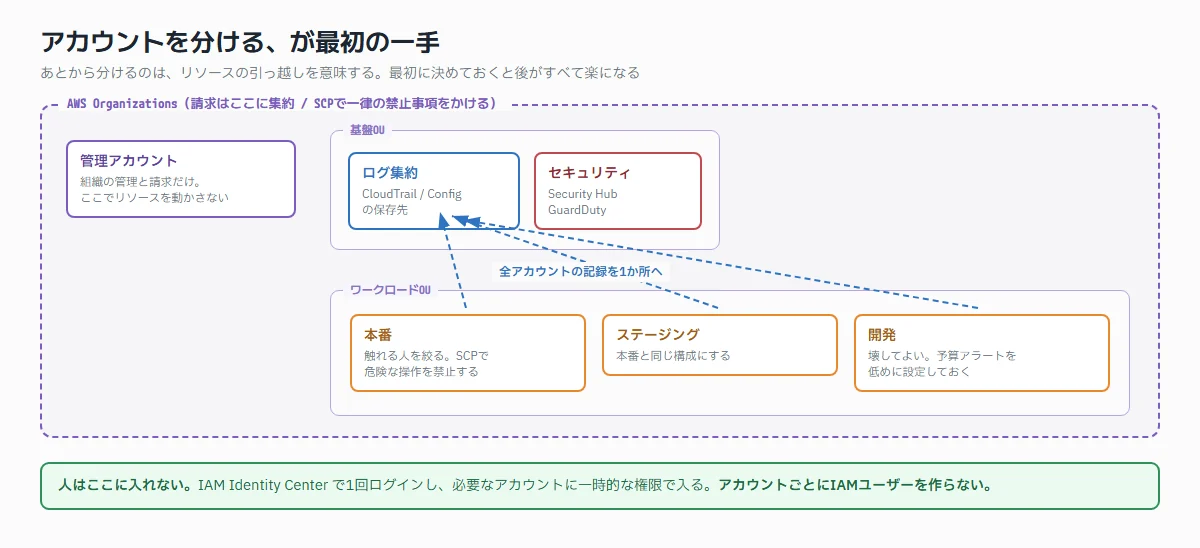
アカウントを分ければ、これらは「境界」で自動的に解決します。権限もコストも上限も、アカウント単位で分かれるからです。アカウントの作成自体は無料です。
最小構成でも次の3つは分けたいところです。
- 管理アカウント
Organizations の管理と請求の集約だけ。ここでリソースを動かさない - 本番
触れる人を絞る - 開発
壊してよい。予算アラートを低めに設定しておく
規模が大きくなったら、ログ集約用とセキュリティ用を足します。監査ログを、監査される側のアカウントに置かないためです。
SCPで「絶対にやらせないこと」を書く
アカウントを分けたら、SCP(サービスコントロールポリシー)で組織全体の禁止事項をかけられます。管理者権限を持っていても超えられない枠なので、事故の上限を決められます。
- 使わないリージョンでのリソース作成を禁止する(IAMの記事で書いた、グローバルサービスの除外を忘れずに)
- CloudTrail の証跡を止める操作を禁止する
- ルートユーザーでの操作を禁止する
2番目が重要です。侵入した攻撃者が最初にやるのは、証跡を消すことです。SCPで禁止しておけば、管理者アカウントが乗っ取られても記録は残ります。
2. 人の入口を1か所にする
アカウントを分けると、今度は「アカウントの数だけログイン情報が増える」問題が出ます。ここで各アカウントにIAMユーザーを作ると、状況は悪化します。
IAM Identity Center を入れて、1回のログインから必要なアカウントに入る形にします。得られるものは3つです。
- 認証情報が一時的になる
長期のアクセスキーが配られなくなります - 退職時の作業が1か所で済む
アカウントごとにユーザーを消して回らなくていい - 誰がどのアカウントに入れるかが一覧できる
棚卸しが可能になります
2番目が実務でいちばん効きます。「退職者のアクセスを止め忘れる」は、アカウントが分散しているほど起きます。
CLIも同じ仕組みで使えるので、~/.aws/credentials にアクセスキーを書く運用をやめられます。
aws configure sso
aws s3 ls --profile prod        # 一時的な認証情報が自動で発行される
3. 記録は最初から全部残す
記録の設定は「あとから有効にしても、過去は取れない」のが特徴です。障害や不正が起きてから入れても、その事象の記録はありません。
| 何を記録するか | 答えられるようになる問い |
|---|---|
| CloudTrail | 誰が、いつ、どのAPIを呼んだか |
| AWS Config | この設定は、いつ、誰が変えたか |
| VPCフローログ | どこからどこへ通信したか |
| アプリケーションログ | その処理で何が起きたか |
CloudTrail と Config は全アカウントで有効にして、集約用のアカウントに集めます。調査のたびにアカウントを渡り歩くのは現実的ではありませんし、そのアカウント自体が侵害されていれば記録も信用できません。
ただし、記録はそのままコストになります。特にログの取り込みは高く、単価を調べた記事で計算したとおり、1日10GBで月$228です。
- ロググループごとに保持期間を設定する
既定は無期限で、放置すると増え続けます - 長期保管はS3へ
単価が下がり、さらに Glacier に落とせます - デバッグログを本番で出さない
ここが量の大半を占めることがあります
ログの中身の設計はログ設計の記事に分けて書きました。「残す」と「後から引ける」は別の問題です。
4. タグを最初に決める
タグは後からでも付けられますが、「既存の全リソースに一括で付ける」作業が発生するので、早いほうが安上がりです。
最低限これだけあれば足ります。
Env         = production | staging | development
Service     = api | batch | web
Owner       = チーム名(誰に聞けばいいか)
ManagedBy   = terraform | manual
効いてくるのは Owner と ManagedBy です。
Owner
「これ何ですか」と聞ける相手が分かります。担当者が辞めたあとに残る、正体不明のリソースが減りますManagedBy
手で消していいかどうかが分かります。Terraform管理のものをコンソールで消すと、次のapplyで復活するか、状態がずれます
タグ付けを徹底するには、タグポリシーで必須化するか、IaCのモジュール側でデフォルトタグを付けるのが現実的です。人の運用に任せると必ず抜けます。
5. コストの見張りを先に置く
コストの事故は、気づくのが1か月後になるのが最大の問題です。請求書で気づいたときには、すでに1か月分使っています。
- AWS Budgets
金額のしきい値で通知する。実績だけでなく「予測」でも通知を設定しておくと、月半ばで気づけます - Cost Anomaly Detection
いつもと違う使われ方を検出する。しきい値を決めなくていいので、最初に入れやすい - 開発アカウントには低めの予算
検証で立てたものを消し忘れたときに、すぐ気づけます
とくに予測での通知は入れておく価値があります。月初に大きなリソースを立てたまま放置すると、実績が閾値に届くのは月末ですが、予測なら数日で分かります。
6. 引き継げる状態にしておく
最後は仕組みではなく、書き物の話です。運用で本当に困るのは、作った人がいなくなったときです。
必要なドキュメントは、多くの場合2種類だけです。
- 構成図
何がどこにあるか。構成図の記事で書いたように、目的別に分けて描く - Runbook
起きうる事象ごとに、確認すること・やることを手順で書く
Runbook で大事なのは「アラートから引ける」ことです。アラートの通知文に、対応するRunbookのリンクを入れておきます。深夜に叩き起こされた人が、通知を見てから対応を始められる状態が目標です。
そして書いただけで終わらせないことです。手順書は、実際に別の人がその手順どおりに操作できたときに初めて完成します。障害訓練でも、新メンバーの受け入れでも構いません。一度も使われていない手順書は、たいてい途中で詰まります。
まとめ
- アカウントを分ける
権限・コスト・上限・事故の範囲が、境界で自動的に分かれる - SCPで「絶対にやらせないこと」を書く
証跡を止める操作は必ず禁止する - 人の入口は1か所に
退職時の作業が1か所で済むのが最大の利点 - 記録は最初から
あとから有効にしても過去は取れない。ただし保持期間は必ず設定する - タグは
OwnerとManagedByが効く
聞ける相手と、手で消していいかが分かる - コストは「予測」で通知する
実績で気づくと1か月遅れる - Runbookはアラートから引けるように
一度も使っていない手順書は詰まる
どれも派手さはありませんが、やっていないと後から効いてくるものばかりです。上から順に、着手できるところから潰していくのが結局いちばん早いと思います。
次に読む記事