監視の設定でいちばん多い間違いは、平均値でアラートを組むことだと思います。「平均レスポンスタイムが500msを超えたら通知」という設定は、一見まともに見えて、実際にはほとんど鳴りません。
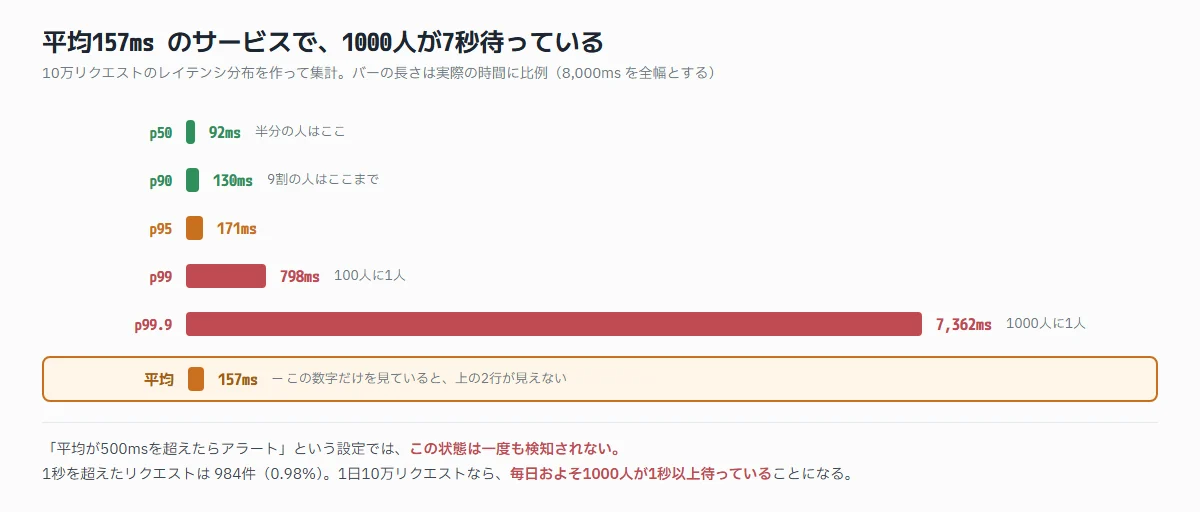
どれくらい鳴らないのかを、実際に数字で出してみました。10万リクエスト分のレイテンシ分布を作って集計したものです。
| 指標 | 値 | 意味 |
|---|---|---|
| 平均 | 157ms | 健全に見える |
| p50(中央値) | 92ms | 半分の人はここ |
| p90 | 130ms | 9割の人はここまで |
| p99 | 798ms | 100人に1人 |
| p99.9 | 7,362ms | 1000人に1人 |
パーセンタイルの読み方
p90・p99 は、値を小さい順に並べたときに下から90%・99%の位置にある値です。この表なら、p99 が798msというのは「99%のリクエストは798ms以内に返っていて、残りの1%がそれより遅い」という意味になります。p50(中央値)はちょうど真ん中、p99.9 は1000回に1回の遅さです。順番で決まる値なので、平均と違って一部の極端に遅い値に引っぱられません。
1秒を超えたリクエストは984件、全体の0.98%でした。1日10万リクエストのサービスなら、毎日およそ1000人が1秒以上待っていることになります。
それでも平均は157ms です。「500msを超えたら通知」というアラートは、一度も鳴りません。
なぜ平均は使えないのか
レイテンシの分布は左に寄って、右に長い尾を引きます。ほとんどのリクエストは速く、一部だけが極端に遅い、という形です。この形のデータでは、平均は分布のどこも表していません。
実際、上の例では平均157ms に対して中央値は92ms です。平均は「ほとんどの人の体験」より遅く、「困っている人の体験」より圧倒的に速いという、誰の実感とも合わない数字になっています。
さらに困るのが、平均は薄まることです。遅いリクエストが2倍に増えても、全体の99%が速ければ平均はほとんど動きません。問題が悪化しても、グラフはほぼ横ばいに見えます。
CloudWatch のメトリクスは、統計の種類を Average / p99 のように選べます。アラームを作るときに、まずここを変えるだけで検知できるものが変わります。
- p90〜p95
全体的な傾向を見る。日常的なダッシュボード向け - p99
アラートの基準にしやすい。「100人に1人が困っている」を検知できる - 最大値
1件でも外れ値があると跳ねるので、アラートには向かない
何を監視するかを先に決める
CloudWatch は放っておくとメトリクスが増え続けます。全部にアラートを付けると、鳴りすぎて誰も見なくなります。
基準として使いやすいのは、「ユーザーが困っているかどうかが分かる指標」を最優先にするという考え方です。
| 種類 | 見るもの | 優先度 |
|---|---|---|
| ユーザーへの影響 | エラー率、レイテンシのp99、リクエスト数の急減 | 最優先。すぐ起こす |
| 枯渇の予兆 | ディスク残量、コネクション数、キューの滞留 | 翌営業日でよい |
| リソース使用率 | CPU、メモリ | 単体ではアラートにしない |
3行目に違和感があるかもしれませんが、CPU使用率が高いこと自体は問題ではありません。90%で回っていてもレスポンスが速いなら、それは効率よく使えているということです。逆にCPUが20%でも、DBのロック待ちで全部詰まっていれば障害です。
CPUは「原因を調べるときに見るもの」であって、「異常を検知するもの」ではないと分けて考えると、アラートの数がかなり減ります。
データが来ないときの挙動を決める
CloudWatch アラームでいちばん見落とされるのが treatMissingData の設定です。メトリクスが1つも届かなかったときにどう扱うかを決めるもので、既定は「欠損として扱う(アラーム状態を変えない)」です。
| 設定 | データが来なかったとき |
|---|---|
missing(既定) | 状態を変えない |
notBreaching | 正常として扱う |
breaching | 異常として扱う |
ignore | 評価しない |
ここが重要なのは、「サーバーが完全に落ちた」ときはメトリクスが送られてこないからです。エラー率のアラームを missing のままにしておくと、本当に全滅したときだけ鳴らないという事態が起きます。
- 「動いていることを確認したい」系のアラーム →
breaching(来なければ異常) - 断続的にしか発生しない処理(バッチなど)→
notBreachingかignore
加えて、「一定時間内に成功が1回もなければ異常」という組み方のほうが、落ちたことを検知しやすくなります。エラーの数ではなく、成功の数を見るという発想です。
しきい値は「静的」か「相対」か
固定値のしきい値には限界があります。アクセスが10倍になる日もあれば、深夜でほぼゼロになる時間帯もあるからです。
- 率で見る
エラーの「件数」ではなく「エラー率」。件数だと、アクセスが増えただけで鳴ります - 異常検出を使う
CloudWatch の Anomaly Detection は、過去のパターンから想定範囲を学習して、そこから外れたときに鳴ります。曜日や時間帯の周期がある指標に向いています - 複合アラームにする
「エラー率が高い」かつ「リクエスト数が一定以上」のときだけ鳴らす。深夜に2件中1件失敗して50%になる、といった誤検知を防げます
3つ目は特に効きます。率だけで見ると、母数が小さいときに簡単に跳ねます。
1回の跳ねで起こさない
しきい値を超えた瞬間に鳴らすと、一時的なスパイクで夜中に起こされます。CloudWatch アラームには「N回の評価のうちM回超えたら」という指定があります。
評価期間     : 1分
データポイント : 5回中3回超えたらアラームこの設定なら、1分だけ跳ねても鳴りません。5分の間に3分以上おかしい状態が続いて、初めて通知されます。
ここで意識したいのは検知までの遅れとのトレードオフです。上の設定では、異常が始まってから通知まで最短でも3分かかります。決済のように1分の停止が痛い処理では短く、バッチのように多少遅れても構わない処理では長く、と用途で変えます。
もう1つ、復旧したときの通知も設定します。アラームが解除されたことが分からないと、対応した人以外は「まだ壊れている」と思ったままになります。
「サーバーは生きているのに使えない」を捕まえる
ここまでの指標は、すべてサーバー側から見た数字です。これだけでは検知できない障害があります。
- 証明書が期限切れになり、ブラウザが接続を拒否している
- DNSの設定ミスで、そもそもサーバーにたどり着けていない
- CDNの設定変更で、古いページが配信され続けている
- JavaScriptのエラーで、画面は出るがボタンが動かない
どれもサーバーのメトリクスは完全に正常です。エラー率0%、レイテンシ良好、CPUも問題なし。それでもユーザーは何もできません。
これを捕まえるには、外から実際にアクセスして確かめる監視が要ります。CloudWatch Synthetics のように、一定間隔でブラウザを動かして「トップページが開けるか」「ログインできるか」を確認する仕組みです。
全機能を網羅する必要はありません。「これが動かなければサービスとして成立しない」という導線を1〜2本だけ用意すれば、上に挙げた障害のほとんどは検知できます。
証明書の期限は、それだけで別に監視しておく価値があります。期限切れは必ず事前に分かるのに、実際にはよく起きる障害だからです。
鳴らすなら、対応できる形で
アラートの目的は「気づくこと」ではなく「対応すること」です。この基準で見ると、多くのアラートは要件を満たしていません。
- 誰が対応するかが決まっているか
全員に飛ぶ通知は、全員が「誰かが見るだろう」と思います - いま対応すべきか、明日でいいかが分かるか
同じチャンネルに両方流れると、区別がつきません - 何をすればいいかが書いてあるか
アラートの通知文に確認手順や対応手順へのリンクを入れておきます - 鳴ったら必ず何かするか
「またこれか」で閉じるアラートは、設定が間違っています
最後が本質だと思います。対応しないアラートを放置すると、本物のアラートも同じ扱いになります。これはログ設計のときに書いたノイズの問題とまったく同じ構造です。
定期的に「この1か月で鳴ったアラートのうち、実際に対応したものはどれか」を見返して、対応しなかったものを消すか、しきい値を直すのが現実的な運用だと思います。
コストの見落とし
監視は入れれば入れるほど良い、とはならない理由がもう1つあります。CloudWatch は使った分だけ課金されます。
- カスタムメトリクス
メトリクスの数で課金される。ディメンションの組み合わせが増えると、メトリクス数が掛け算で増えます - ログの取り込み量
取り込んだGB数で課金。デバッグログを本番で出していると、ここが大きくなります - ログの保管期間
既定は「無期限」。設定しないと増え続けます
特に見落としやすいのが最後です。ロググループの保持期間を明示的に設定していないと、削除されません。作った覚えのないロググループが何年分も残っている、というのはよくあります。
ディメンションの掛け算も注意が必要です。「エンドポイント × ステータスコード × リージョン」のように分けると、便利ではありますがメトリクス数が急増します。後から絞るのは大変なので、最初に必要な粒度を決めておくほうが安全です。
まとめ
- 平均は使わない
平均157ms のサービスで、1000人に1人は7秒待っていた - アラートはp99で組む
平均では悪化してもグラフが動かない - CPUは検知ではなく調査のための指標
単体でアラートにしない treatMissingDataを必ず決める
既定のままだと、全滅したときに鳴らない- 件数ではなく率で、かつ母数の条件を付ける
複合アラームで誤検知を減らす - 対応しないアラートは消す
放置すると本物も無視されるようになる - ログの保持期間を設定する
既定は無期限で、放っておくと増え続ける
次に読む記事