RDSはマネージドサービスですが、「放っておいても大丈夫な部分」と「自分で設計しないと事故る部分」がはっきり分かれています。バックアップの取得やパッチ適用はAWSがやってくれますが、失敗の仕方を知らないまま運用に入ると、障害のときに初めて設計の穴に気づくことになります。
この記事では、PostgreSQLをRDSで本番運用するときに、先に決めておかないと後から効いてくる項目を整理します。
Multi-AZ とリードレプリカを混同しない
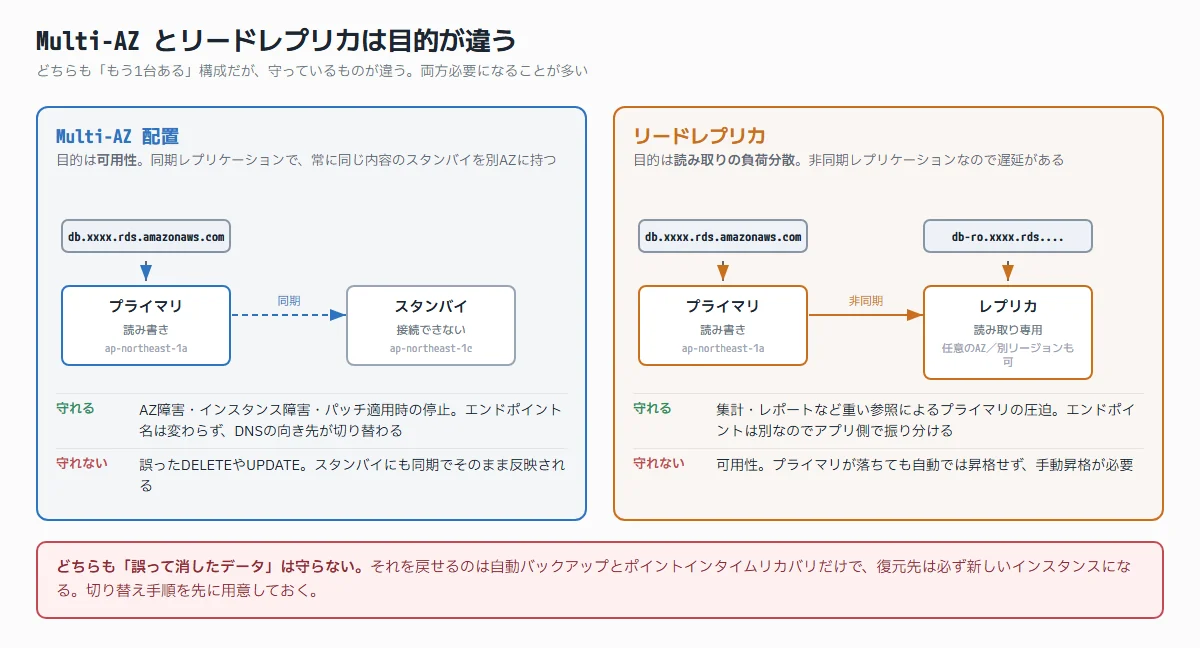
どちらも「もう1台ある」構成ですが、目的が違います。
| Multi-AZ 配置 | リードレプリカ | |
|---|---|---|
| 目的 | 可用性 | 読み取りの負荷分散 |
| レプリケーション | 同期 | 非同期(遅延あり) |
| 接続 | スタンバイには接続できない | 専用エンドポイントで読み取り可 |
| 障害時 | 自動フェイルオーバー | 自動では昇格しない |
| エンドポイント | 変わらない | プライマリとは別 |
「Multi-AZ にしたからリードレプリカは要らない」も「レプリカがあるから可用性は大丈夫」も、どちらも成立しません。負荷分散と可用性は別の問題なので、必要ならどちらも入れます。
そして重要なのは、この2つはどちらも「間違って消したデータ」を守らないことです。同期レプリケーションは誤ったDELETEも忠実にコピーしますし、リードレプリカにも遅れて反映されます。データを戻せるのはバックアップだけです。
料金は何が増えるのか
Multi-AZ はスタンバイをもう1台持つ構成なので、インスタンスもストレージも2台分かかります。東京リージョンのPostgreSQLの単価で並べると、きれいに2倍です。
| 項目 | シングルAZ | Multi-AZ |
|---|---|---|
| db.m6g.large | 1時間 0.221ドル | 1時間 0.441ドル |
| gp3 ストレージ | 1GB 月 0.138ドル | 1GB 月 0.276ドル |
| gp3 の追加IOPS | 1 IOPS 月 0.024ドル | 1 IOPS 月 0.048ドル |
ただし、プライマリとスタンバイの間のレプリケーションで発生するデータ転送に料金はかかりません(AWSのFAQに明記されています)。「Multi-AZ にすると転送量でも取られるのでは」という心配は要りません。増えるのは台数分の固定費です。ただしこれはRDSの中のレプリケーションの話で、アプリからDBへの通信がAZをまたぐ分は通常どおり課金されます(東京リージョンで1GBあたり0.01ドル)。
リードレプリカは、1台増やすごとにインスタンスとストレージがもう1セット増えます。加えて別リージョンに置くと、ソースのリージョンから出ていくデータに転送料金がかかります。作成時のスナップショットの転送と、その後の変更分の転送の両方が対象です。
フェイルオーバーでアプリ側に起きること
Multi-AZ のフェイルオーバーは、エンドポイント名はそのままで、DNSの向き先がスタンバイのIPに切り替わるという動きをします。ここにアプリ側の落とし穴があります。
- DNSをキャッシュし続ける
JVMのように、名前解決の結果を長時間(設定によっては無期限に)キャッシュする実行環境では、切り替わったあとも古いIPにつなぎ続けます。TTLを尊重する設定にしておく必要があります - 接続プールが古い接続を持ち続ける
プール内のコネクションは切断されて初めて作り直されます。切断検知と、接続の最大生存時間の設定が効きます - 切り替え中の書き込みは失敗する
数十秒のあいだ書き込みができない時間が発生します。リトライ処理がないと、その間のリクエストがそのままエラーになります
つまり「Multi-AZ にしたから大丈夫」はアプリ側の実装まで含めて初めて成立します。RDSにはフェイルオーバーを手動で起こす機能があるので、本番投入前に一度実際に発生させて、アプリがどう振る舞うか確認しておくのが確実です。
パラメータグループは適用タイミングに注意
デフォルトのパラメータグループは編集できないので、カスタムのものを作って適用します。最低限、次のあたりは最初に設定しておきます。
resource "aws_db_parameter_group" "postgres" {
  family = "postgres16"
  name   = "production-postgres16"

  # 1秒以上かかったクエリをログに出す
  parameter {
    name  = "log_min_duration_statement"
    value = "1000"
  }

  # 実行計画の統計を取る(Performance Insights と併用する)
  parameter {
    name  = "shared_preload_libraries"
    value = "pg_stat_statements"
    apply_method = "pending-reboot"   # static パラメータ
  }

  # ロック待ちを検知する
  parameter {
    name  = "log_lock_waits"
    value = "1"
  }
}
ここで詰まりやすいのが static と dynamic の区別です。
- dynamic
変更するとすぐ反映される(log_min_duration_statementなど) - static
インスタンスを再起動しないと反映されない(shared_preload_libraries、shared_buffersなど)
staticなパラメータを変更しただけで「設定した」と思い込むと、実際には効いていない状態で運用が始まります。変更後にパラメータグループのステータスが pending-reboot になっていないかを必ず確認します。
# 反映待ちのパラメータが残っていないか確認する
aws rds describe-db-instances \
  --db-instance-identifier my-db \
--query 'DBInstances[0].DBParameterGroups'メモリ系のパラメータは、{DBInstanceClassMemory/4} のような式で書けます。インスタンスクラスを変えたときに追従してくれるので、固定値よりこちらが安全です。
運用中に見るクエリ(PostgreSQL)
マネージドコンソールだけでは分からないことがあります。手元に置いておくクエリをいくつか挙げます。ここから先は RDS for PostgreSQL を前提にしたクエリです。MySQL なら SHOW PROCESSLIST や information_schema.innodb_trx が同じ役割になります。
長時間実行中のクエリを探す
SELECT pid, now() - query_start AS duration, state, left(query, 80)
FROM pg_stat_activity
WHERE state <> 'idle'
  AND now() - query_start > interval '30 seconds'
ORDER BY duration DESC;
pg_stat_activity は、いま接続しているセッションの一覧です。このクエリはそこから実行中(state が idle 以外)で、開始から30秒以上たっているものを、長い順に並べています。duration は now() - query_start なので「そのクエリが何秒走り続けているか」、left(query, 80) はクエリ本文が長くなりがちなので先頭だけを出しています。
30秒はしきい値の例です。バッチが動く時間帯なら長めに、オンライン処理だけのデータベースなら5秒でも構いません。障害のときに初めて実行するのではなく、平常時にも流して「いつもの並び」を知っておくと、異常かどうかの判断が速くなります。
止めるときは、出てきた pid を使います。
-- クエリだけ止める(接続は残る)
SELECT pg_cancel_backend(12345);

-- それでも止まらないときは、セッションごと切る
SELECT pg_terminate_backend(12345);
pg_cancel_backend は実行中のクエリをキャンセルし、pg_terminate_backend はセッションそのものを終了します。どちらもアプリ側にはエラーとして返るので、リトライやトランザクションの扱いを確認してから実行します。他人のセッションに対して実行するには pg_signal_backend の権限が必要ですが、RDS のマスターユーザーは rds_superuser なので、どの接続でも止められます。
放置されたトランザクションを探す
SELECT pid, now() - xact_start AS xact_age, state, left(query, 80)
FROM pg_stat_activity
WHERE state = 'idle in transaction'
ORDER BY xact_age DESC;
idle in transaction はとくに厄介です。アプリがトランザクションを開いたまま放置している状態で、その間 VACUUM が不要行を回収できません。ディスク使用量がじわじわ増え、テーブルが肥大化し、やがて性能が落ちます。CPU使用率もコネクション数も正常に見えるので、原因にたどり着くのが遅れがちです。
対策として idle_in_transaction_session_timeout を設定し、一定時間で強制的に切断するようにしておきます。
VACUUM の状況を見る
SELECT relname,
       n_live_tup, n_dead_tup,
       round(n_dead_tup * 100.0 / nullif(n_live_tup + n_dead_tup, 0), 1) AS dead_pct,
       last_autovacuum
FROM pg_stat_user_tables
WHERE n_dead_tup > 10000
ORDER BY n_dead_tup DESC;
更新の多いテーブルで dead_pct が下がらず last_autovacuum も古い場合、autovacuum が追いついていません。テーブル単位で autovacuum_vacuum_scale_factor を下げて、実行頻度を上げる調整が要ります。
バックアップは「戻せること」まで確認する
自動バックアップの保持期間は最大35日です。ここで押さえておきたい性質があります。
- ポイントインタイムリカバリの復元先は、必ず新しいインスタンスになる
既存のインスタンスを巻き戻すことはできません - したがって復元後は、アプリの接続先を切り替える作業が必ず発生します
パラメータグループ・セキュリティグループ・サブネットグループの指定も引き継ぎが必要です - インスタンスを削除すると自動バックアップも消えます
残したい場合は削除前に手動スナップショットを取ります - 保持期間を0にすると自動バックアップが無効になり、ポイントインタイムリカバリも使えません
いちばん大事なのは、復元を一度実際にやってみることです。手順書だけ用意して試していないと、本番で焦ることになります。復元先が新インスタンスになる以上、切り替えの所要時間は事前に測っておかないと分かりません。
バックアップの料金
バックアップの保存先はS3で、料金はリージョン単位の合計(自動バックアップ+手動スナップショット)で決まります。そのリージョンでプロビジョニングしているDBストレージの合計までは無料で、超えた分だけが課金されます。東京リージョンの超過分は1GBあたり月0.095ドルです。
つまり請求に出てくるのは、保持期間を長くしたときと、手動スナップショットを消さずに貯めたときです。保持期間を35日にすれば、それだけバックアップの総量も増えます。スナップショットをS3へエクスポートする場合は、別途1GBあたり0.012ドルがかかります。
単価はAWSが公開している料金データ(東京リージョン、2026年9月時点)から取りました。
メンテナンスウィンドウを放置しない
マイナーバージョンアップやOSパッチはメンテナンスウィンドウ中に適用されます。作成時に指定しないと自動で割り当てられるため、知らないうちに業務時間帯に設定されていることがあります。
- アクセスの少ない時間帯に、バックアップウィンドウと重ならないよう設定する
- Multi-AZ ならフェイルオーバーで済むが、それでも切り替えの瞬間に接続断は起きる
- 単一AZ構成の場合は、適用中そのまま停止する
本番で単一AZを選ぶ理由はほぼない
まとめ
- Multi-AZ は可用性、リードレプリカは負荷分散
どちらも誤削除は守らない - フェイルオーバーはDNS切り替え
アプリ側のDNSキャッシュと接続プールとリトライまで含めて設計する - staticパラメータは再起動しないと効かない
設定したつもりを作らない idle in transactionを放置しない
VACUUMが止まり、静かに肥大化する- 復元は新インスタンスに作られる
切り替え手順を用意し、一度実際に試す
マネージドサービスが引き受けてくれるのは作業であって、設計と確認ではありません。分担がどこで切れているかを把握しておくのが、RDS運用の実際のところだと思います。
次に読む記事