Lambda の設計で最初に効くのは、コードをハンドラの中に書くか、外に書くかです。ここを間違えると、毎回の呼び出しで同じ初期化を繰り返します。
どれくらい違うのかを、手元で実際に測りました。50msかかる初期化処理を、同じコンテナで10回呼び出したときの合計です。
同じコンテナで 10 回呼び出したときの合計

  A ハンドラの中で初期化   合計   523.0ms   1回あたり  52.3ms
B ハンドラの外で初期化 合計 0.1ms 1回あたり 0msBも初期化のコスト自体は払っていますが、それはコンテナが起動したときの1回だけです。2回目以降の呼び出しでは何もしません。
INIT と INVOKE を分けて考える
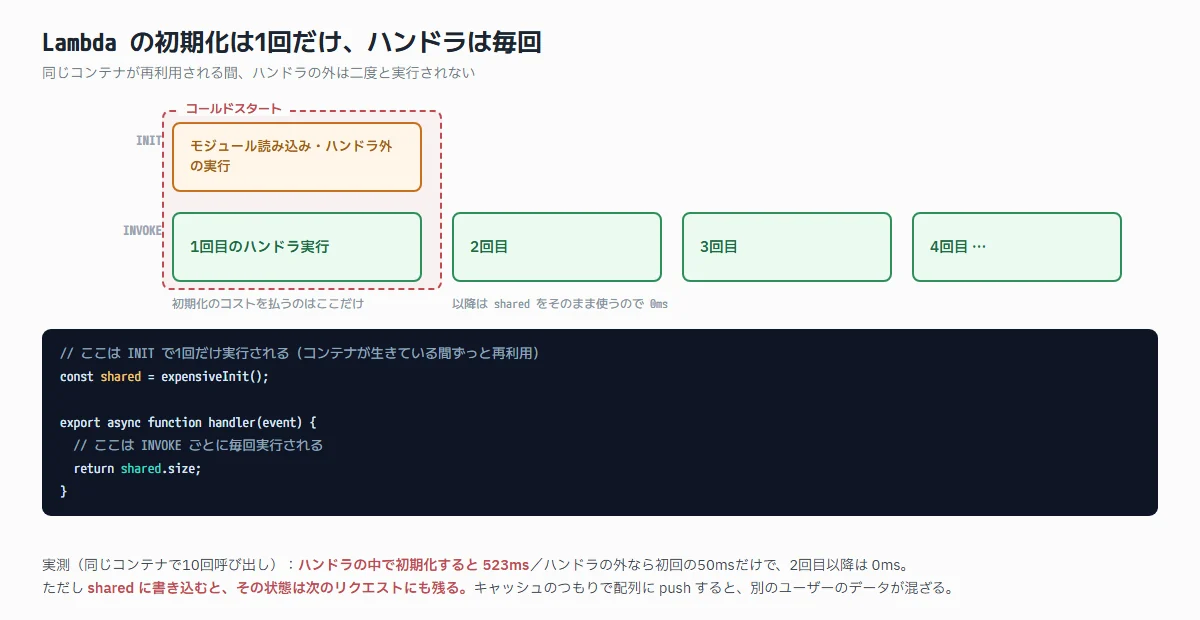
Lambda の実行環境には2つのフェーズがあります。
- INIT
コンテナが起動し、モジュールが読み込まれ、ハンドラの外側のコードが実行される。ここが「コールドスタート」 - INVOKE
ハンドラが呼ばれる。コンテナが再利用される限り、何度も繰り返される
// ここは INIT で1回だけ実行される
const dbClient = new Client(process.env.DB_URL);
const config   = JSON.parse(readFileSync('./config.json'));

export async function handler(event) {
  // ここは INVOKE ごとに毎回実行される
  return dbClient.query(...);
}
ハンドラの外に置くべきものは決まっています。
- SDKクライアントの生成
- データベースへの接続
- 設定ファイルの読み込み・パース
- 正規表現のコンパイル、定数テーブルの構築
ただし1つ注意があります。INIT フェーズで例外が出ると、そのコンテナは起動に失敗します。環境変数の不足などで落ちる場合、エラーの出方が分かりにくくなるので、INIT では「失敗しうる処理」を避けるという判断もあります。接続の確立は遅延させて、最初の呼び出し時に行う設計です。
再利用されるということは、状態が残るということ
ハンドラの外に置いたものが再利用されるのは、都合がいい反面、事故のもとにもなります。実際に動かしてみました。
const cache = [];                    // よくある「キャッシュ」

async function handler(event) {
  cache.push(event.userId);
  return cache.length;
}
u1 のリクエスト後 … 配列の中身: ["u1"](1件)
u2 のリクエスト後 … 配列の中身: ["u1","u2"](2件)
u3 のリクエスト後 … 配列の中身: ["u1","u2","u3"](3件)u3 のリクエストを処理している最中に、u1 と u2 のデータが見えています。これがモジュールスコープに可変の状態を置いたときの挙動です。
怖いのは、ローカルでも、テストでも、まず再現しないことです。1回ずつしか呼ばないので配列は常に1件です。本番でトラフィックが増え、コンテナが再利用されるようになって初めて現れます。
- メモリが増え続ける
コンテナが生きている限り解放されない - 別ユーザーのデータが混ざる
情報漏洩になりうる - 結果が呼び出し順に依存する
同じ入力で同じ出力にならない
原則はシンプルで、ハンドラの外には「読み取り専用のもの」だけを置くことです。接続や設定は共有していいものですが、リクエスト固有のデータを置いてはいけません。キャッシュが必要なら、外部のキャッシュストアを使います。
コールドスタートを減らす
初期化の位置を直したうえで、それでもコールドスタートが問題になる場合の手段です。効果とコストの順に並べます。
| 手段 | 効果 | コスト |
|---|---|---|
| パッケージを小さくする | 読み込み時間が減る | ほぼなし。まずこれ |
| メモリを増やす | CPUも比例して増えるので初期化が速くなる | 単価は上がるが、実行時間が縮んで合計が下がることがある |
| VPCの外で動かす | ENIの準備が不要になる | VPC内リソースにアクセスできない |
| Provisioned Concurrency | 常に温めておく | 使わなくても課金される |
意外に効くのが2番目です。Lambda のCPU性能はメモリ設定に比例します。メモリを2倍にすると処理も速くなるので、「単価2倍 × 実行時間半分」で合計は変わらず、レイテンシだけ改善する、ということが起こります。メモリ設定は、メモリ不足のときだけ触るものではありません。
1番目のパッケージサイズは、依存関係の整理が効きます。SDK全体ではなく必要なクライアントだけを読む、開発用の依存をバンドルから外す、といった基本的なところです。
タイムアウトとリトライの掛け算
設計で見落としやすいのがここです。Lambda がタイムアウトしても、処理が止まるとは限りません。
非同期呼び出しの場合、Lambda は失敗を自動的にリトライします。既定では2回まで再試行されるので、合計3回実行されます。そしてタイムアウトした1回目の処理は、途中まで進んでいます。
- 1回目
DBに書き込んだ直後にタイムアウト - 2回目
同じ処理が最初から走り、もう一度書き込む
これはジョブキューの記事で書いた「少なくとも1回」とまったく同じ問題です。Lambda の関数は冪等に書く必要があります。
タイムアウトの値そのものも設計対象です。
- 長すぎる
詰まった処理が最大時間まで居座り、同時実行数を食う - 短すぎる
正常な処理が途中で切られ、リトライで二重実行される - 呼び出し元より長い
API Gateway の上限は29秒。Lambda を60秒にしても、クライアントには先にタイムアウトが返る
3番目は特に混乱のもとです。クライアントにはエラーが返っているのに、Lambda は裏で処理を続けて成功するという状態になります。ユーザーが「失敗した」と思って再送すると、二重登録になります。
失敗したイベントを捨てない
同期呼び出しなら、失敗はそのまま呼び出し元に返るので気づけます。問題は非同期呼び出しです。3回試して全部失敗したイベントは、何も設定していないと消えます。
「S3にファイルが置かれたら処理する」といった構成で、処理されなかったファイルが黙って放置されることになります。しかもエラーは出ているので、ログを見ていれば分かる、という状態が続きます。
受け止め先を必ず設定します。
- Lambda Destinations
成功時と失敗時で別々の送り先を指定できる。エラーの内容とイベント本体の両方が送られるので、後から調査しやすい - デッドレターキュー
SQSやSNSに送る。イベント本体は入るが、エラーの詳細は付かない
新しく作るなら Destinations のほうが情報量が多くて扱いやすいです。どちらにしても、送り先に何か入ったら通知するところまで作らないと、設定しただけで終わります。
SQSトリガーは「1件失敗すると全部やり直し」
SQS をトリガーにする場合、特有の落とし穴があります。Lambda は複数のメッセージをまとめて1回の呼び出しで受け取ります。バッチサイズが10なら、10件が同時に渡されます。
このとき、10件中1件だけ失敗して関数がエラーを返すと、10件すべてが未処理として扱われ、まるごと再配信されます。成功していた9件も、もう一度処理されます。
ここでも冪等性が効いてきますが、無駄な再処理は減らせます。失敗したメッセージのIDだけを返す仕組み(部分的なバッチ応答)を使うと、成功した分は確定します。
export async function handler(event) {
  const failures = [];
  for (const record of event.Records) {
    try {
      await process(record);
    } catch (e) {
      failures.push({ itemIdentifier: record.messageId });   // 失敗した分だけ返す
    }
  }
  return { batchItemFailures: failures };
}ポイントは、1件の失敗で throw せず、最後まで回してから返すことです。途中で例外を投げると、それ以降のメッセージは処理されないまま全件再配信になります。イベントソースマッピング側でこの機能を有効にする設定も必要です。
同時実行数はアカウント全体で共有される
もう1つ、影響範囲が読みにくいのが同時実行数です。上限はアカウントとリージョン単位で共有されます。
つまり、ある関数が大量に呼ばれて枠を使い切ると、まったく無関係な別の関数がスロットリングされます。バッチ処理が動いた時間帯だけAPIが落ちる、という現象はこれが原因のことがあります。
対策は、関数ごとに予約同時実行数を設定して枠を区切ることです。重要な関数には確保し、バッチ系には上限を設けます。これは「その関数が使える最大数」でもあるので、設定しすぎると逆に詰まる点には注意が必要です。
下流にも同じ考え方が要ります。Lambda が1000並列で立ち上がると、接続先のRDSにも1000本の接続が来ます。Lambda はスケールしても、データベースの接続数上限はスケールしません。RDS Proxy のような接続を集約する仕組みを挟むか、予約同時実行数で上限を切ります。
まとめ
- 初期化はハンドラの外へ
10回の呼び出しで523ms と 0.1ms の差になった - 外に置けるのは読み取り専用のものだけ
可変の状態は次のリクエストに残る - 状態の混入はローカルで再現しない
本番でコンテナが再利用されて初めて出る - メモリ設定はCPU性能でもある
増やすと合計コストが下がることがある - 非同期呼び出しは最大3回実行される
関数は冪等に書く - 同時実行数はアカウント共有
別の関数の影響を受ける。下流の接続数にも注意する
次に読む記事