BtoCサービス(数万ユーザー規模)を、EC2からECS Fargateに移行しました。業務のシステムなので構成の詳細は書けませんが、やってみて意外だったところを残しておきます。
結論から言うと、いちばん心配していた切り替えは体感0秒で終わり、詰まったのはビルドとリリース速度のほうでした。
移行前に洗い出したこと
EC2で動いていたものをそのままコンテナに入れると動かない、という項目を先に潰します。コンテナは「いつ止まってもいい」前提なので、そこに反するものが障壁になります。
| EC2でやっていたこと | コンテナでの扱い |
|---|---|
| ローカルディスクへの書き込み | コンテナが消えると失われる。S3か、共有ストレージのEFSへ |
| ファイルベースのセッション | タスクが複数あると共有されない。Redis等へ |
| ログファイルへの出力 | 標準出力に出して CloudWatch Logs へ。コンテナ内のファイルに書くと、タスクが入れ替わったときに読めなくなる |
| cron | Webのタスクに同居させない。EventBridge + 別タスクへ |
| OSに入れた個別の設定 | Dockerfileに書けるかを確認する |
cronは特に注意が必要です。Webのコンテナに同居させると、タスク数を2つに増やした瞬間にバッチが二重に走ります。スケールアウトが目的の移行で、これは本末転倒です。
ヘルスチェックの向き先も気をつけたいところです。コンテナ内から自分自身を叩くので、外部のURLではなく localhost を指定します。
HEALTHCHECK --interval=30s --timeout=3s \
  CMD curl -f http://localhost/health || exit 1
切り替えは体感0秒だった
移行でいちばん怖いのは切り替えの瞬間です。ここはBlue/Greenデプロイにしました。
- 新しい環境(Green)を本番と並べて立てる
- そちらだけを別ポートで開けて、動作をひととおり確認する
- 問題がなければ、ロードバランサーの向き先を切り替える
本番切り替えの前に、切り替えテスト自体も実施しました。実際にやってみて、体感では0秒でした。接続が切れることも、エラーが出ることもありませんでした。
この方式の安心感は、「切り戻しも同じ操作でできる」ところにあります。何かあれば向き先を戻すだけなので、判断が速くなります。「移行して駄目なら戻す」が現実的な選択肢として存在していると、当日の緊張がかなり違いました。
不安だった部分が、事前にテストできる形になっていたおかげで拍子抜けするほど静かに終わった、という感想です。
実際に詰まったのはビルドだった
CI/CDは CodePipeline で組みました。ここで、移行前には想像していなかった困り方をしました。
ビルドが単に長いのか、失敗してループしているのかが分からないという状態です。
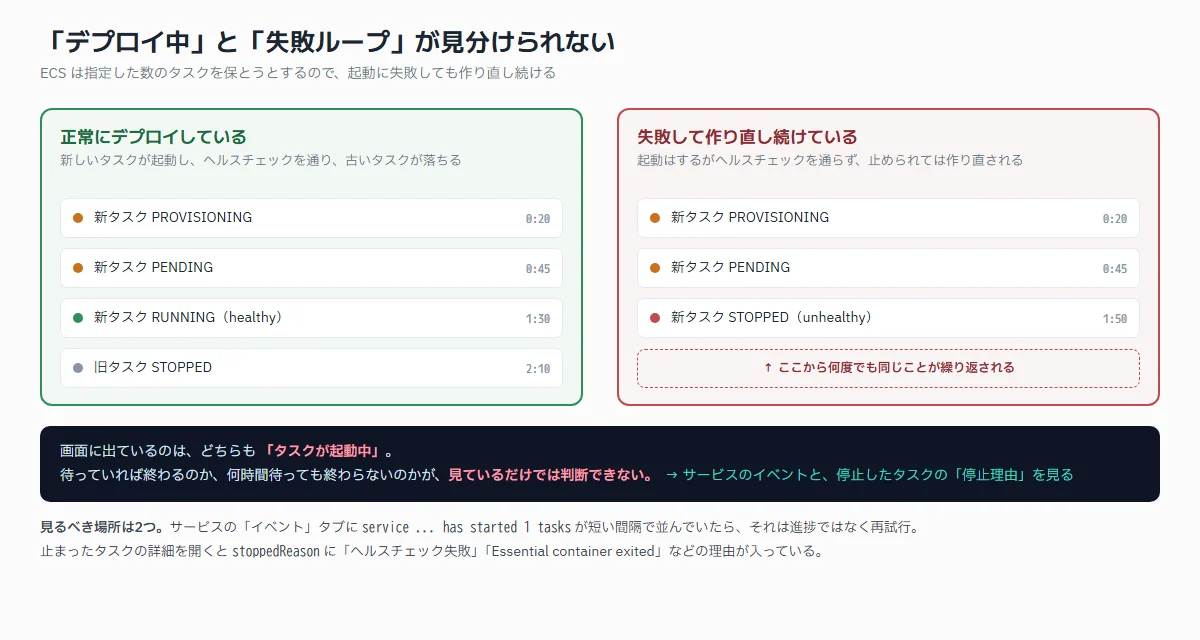
原因は、ECSの基本的な性質にあります。ECSサービスは「タスクを指定した数だけ保つ」ように動きます。タスクが起動に失敗して止まっても、数が足りなくなるので、また新しいタスクを立ち上げます。
その結果、設定によっては、失敗するたびにコンテナが作り直され続けます。画面で見えるのは「タスクが起動中」で、これは正常にデプロイしているときとほとんど同じ表示です。
- 正常なとき
起動 → ヘルスチェック通過 → 旧タスクが落ちる - 失敗しているとき
起動 → ヘルスチェック失敗 → 止まる → また起動
どちらも「新しいタスクが起動しようとしている」ので、パッと見では区別がつきません。待っていれば終わるのか、何時間待っても終わらないのかが判断できないのが、いちばん時間を溶かした部分でした。
見分ける方法
結局、見るべき場所は2つでした。
- サービスの「イベント」タブ
「タスクを起動した」という記録が短い間隔で並んでいたら、それは進捗ではなく再試行です - 停止したタスクの「停止理由」
タスクの詳細を開くと、ヘルスチェック失敗なのか、コンテナがすぐ終了したのかが書いてあります
知ってしまえば当たり前ですが、EC2で運用していたときには存在しなかった見方です。EC2なら、サーバーにログインしてプロセスとログを見れば分かりました。コンテナはログインする先が消えていくので、同じやり方が通じません。
あわせて、デプロイの失敗を自動で検知して止める設定を入れておくと、この状態自体を減らせます。一定回数失敗したらデプロイを止めて前の状態に戻す、という動きにしておけば、延々と作り直され続けることはなくなります。
想定外だったこと:リリースが遅くなった
移行後に、思っていたのと違ったのがここです。
ちょっとした修正でも、ビルド・テスト・デプロイの全工程が走ります。そのぶんリリースまでの時間が、想像していたよりかかりました。
EC2で運用していたときは、極端に言えばファイルを置き換えれば反映されていました。文言の修正1文字でも、いまはコンテナイメージをビルドし直して、テストを流して、デプロイを待つことになります。
もちろん、これは移行して得たものと引き換えです。
| 得たもの | 引き換えに失ったもの |
|---|---|
| 本番と同じものをテストできる | 1行の修正でも全工程が走る |
| 切り戻しが確実にできる | 反映までの時間が長くなる |
| サーバーの管理が要らない | 手元での「ちょっと直す」ができない |
| スケールアウトが容易 | コンテナ前提の作りに直す必要がある |
「ファイルを置き換えれば反映される」状態は、速い代わりに本番にしか存在しない状態を作れてしまうということでもあります。そこを塞いだ結果としての遅さなので、これ自体は悪いことではありません。
ただ、移行を提案する段階で「リリースにかかる時間は増えます」と伝えておくべきだったとは思います。運用する人にとっては体感の変化が大きい部分です。
短くしたいなら、パイプラインを見直す余地はあります。依存関係のインストールをキャッシュする、ビルドを並列にする、影響範囲の小さい変更ではテストを間引く、といったところです。移行が終わってからの改善項目として残っています。
これから移行する人へ
- 切り替えは、Blue/Greenにすれば思ったより怖くない
事前にテストできて、切り戻しも同じ操作でできる - 怖いのは切り替えではなく、その後の運用の見方が変わること
EC2の感覚のままだと、状況が読めなくなる - 「デプロイ中」と「失敗ループ」の見分け方を、移行前に知っておく
イベントと停止理由を見る - リリースにかかる時間は増える
関係者に先に伝えておく - cronとセッションとログ出力先は、必ず先に洗い出す
あとで気づくと作り直しになる
移行そのものより、移行後の運用が別物になることの準備のほうが大事だった、というのが実際にやってみての感想です。
次に読む記事