Web アプリを運用していると、「最近ちょっとレスポンスが遅い」「ピーク時にタイムアウトが出る」「インフラ費が地味に膨らんでいる」といった声が必ず出てきます。
こうしたとき、つい 「スケールアップして様子を見る」 という対症療法に走りがちですが、多くの場合は アプリ側 or データ側にもっと根本的な原因 が隠れています。
この記事では、コードもインフラもまとめて見直すときの王道アプローチを、SQL 最適化・キャッシュ戦略・不要リソース整理 の3つを軸に整理します。
1. まず「計測」から始める
パフォーマンス改善でいちばんやってはいけないのが、計測せずにいきなり手を入れる ことです。「たぶんここが遅いはず」で改修してもほぼ外します。
最低限、以下は揃えておきたいところ。
- APM ツール(Datadog APM / New Relic / Sentry Performance など)でリクエストごとのレイテンシ内訳を可視化
- スロークエリログを必ず有効化(MySQL なら
slow_query_log、PostgreSQL ならlog_min_duration_statement) - p50 / p95 / p99 のレイテンシを見る(平均だけ見ると重要な悪化を見逃す)
計測した結果、「リクエスト全体の8割の時間がDB待ちだった」 ということもザラにあります。そのケースで CPU を増やしても効果はほぼゼロです。
WordPress なら、クエリ本数は数行で測れる
このブログ(WordPress + SWELL、Cloudflare 経由)で実際に測った例を載せておきます(2026年9月9日)。PHP のプロファイラを入れなくても、$wpdb->num_queries を前後で引くだけでクエリ本数が分かります。
global $wpdb;
wp_cache_flush();                 // 前のケースの結果を持ち越さない
$n0 = $wpdb->num_queries;
$t0 = microtime( true );

// ここに測りたい処理

printf( "クエリ %d 本  %.1f ms\n",
    $wpdb->num_queries - $n0,
    ( microtime( true ) - $t0 ) * 1000 );
大事なのが wp_cache_flush() です。これを入れないと2回目以降がオブジェクトキャッシュに当たって、実際より少ない本数が出ます。 「速くなった」と思ったらキャッシュを測っていただけ、というのはよくある失敗です。
2. SQL クエリ最適化
多くの Web アプリで、レスポンス時間の支配項は DB クエリ です。ここを叩くと最も費用対効果が高いです。
2-1. N+1 クエリを潰す
ORM を使っているとほぼ確実に発生するのが N+1 問題。リストを取得したあとに、各要素ごとに関連テーブルへ追加 SELECT が走るパターンです。
# 悪い例:ユーザー数 N に対して N+1 回のクエリ
users = User.objects.all()
for u in users:
    print(u.profile.bio)   # ← ここで毎回 SELECT が走る

# 良い例:JOIN で1回にまとめる
users = User.objects.select_related("profile").all()
for u in users:
    print(u.profile.bio)
ORM の eager loading / preload / JOIN 系のメソッドを使って、「リクエスト1回 = クエリ数定数」 を目指します。
このブログで再現してみた
N+1 は言葉で説明されても実感が湧きにくいので、同じ画面を3通りの書き方で出して本数を比べました。10件の記事一覧に、アイキャッチとカテゴリを付けて表示するケースです。
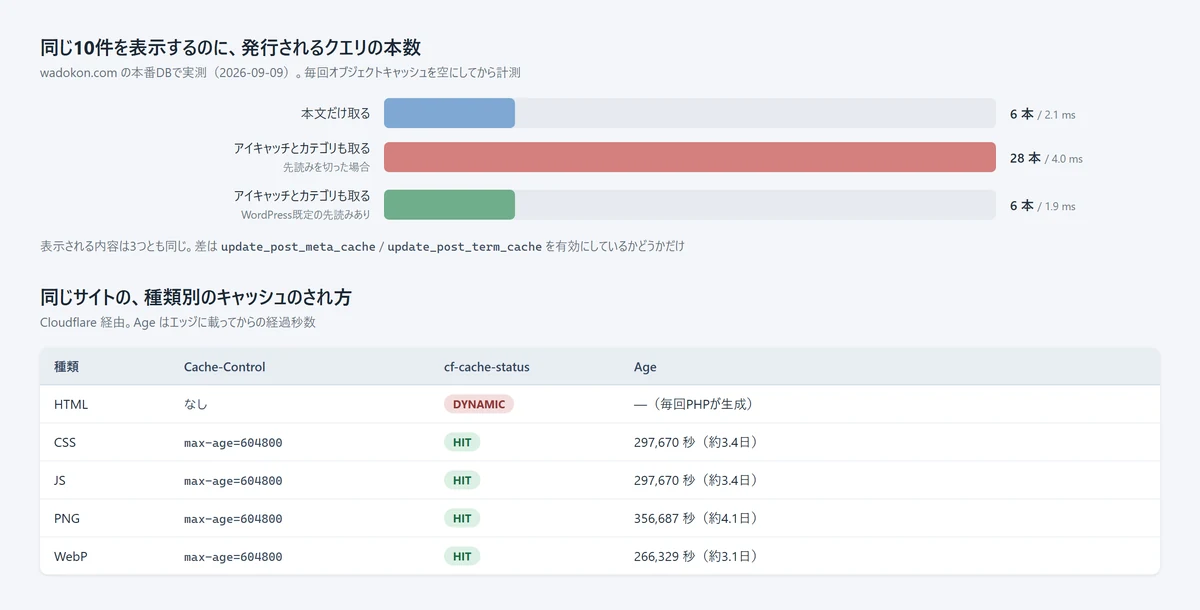
本文だけ取る                              クエリ   6 本   2.1 ms
アイキャッチとカテゴリも取る(先読みを切る)    クエリ  28 本   4.0 ms
アイキャッチとカテゴリも取る(既定のまま)      クエリ   6 本   1.9 ms
表示される内容は3つとも同じです。 差は次の2つのオプションを切ったかどうかだけでした。
// 先読みを切ると、1件ごとに meta と term を取りに行く
$q = new WP_Query( [
    'post_type'              => 'post',
    'posts_per_page'         => 10,
    'no_found_rows'          => true,
    'update_post_meta_cache' => false,   // ← これ
    'update_post_term_cache' => false,   // ← これ
] );
foreach ( $q->posts as $p ) {
    get_post_thumbnail_id( $p->ID );     // 1件ごとに1本
    get_the_terms( $p->ID, 'category' ); // 1件ごとに1本
}
WordPress は既定で、ループに入る前に10件分の meta と term をまとめて1本ずつ取るようになっています。これを切ると1件ごとに取りに行くので、10件 × 2種類 = 20本余分に増えて28本になりました。
既定のまま(6本)のときに実際に流れていた SQL がこれです。
1回  SELECT option_name, option_value FROM wp_options WHERE autoload IN (...)
1回  SELECT wp_posts.ID FROM wp_posts WHERE ... LIMIT 0, 10
1回  SELECT wp_posts.* FROM wp_posts WHERE ID IN (N,N,N,N,N,N,N,N,N,N)
1回  SELECT post_id, meta_key, meta_value FROM wp_postmeta WHERE post_id IN (N,...)
1回  SELECT DISTINCT t.term_id, tr.object_id FROM wp_terms AS t INNER JOIN ...
1回  SELECT t.*, tt.* FROM wp_terms AS t INNER JOIN wp_term_taxonomy AS tt ...
WHERE post_id IN (N,N,...) の1本が、切った場合の10本に相当します。N+1 を潰すというのは、要するにこの IN の形に持っていくことです。
ミリ秒はたいして変わらない
正直に書くと、4.0 ms と 1.9 ms なので体感では分かりません。 このブログはまだ記事数が少なく、DBも小さいからです。
ただし、ここで効くのは件数と同時アクセス数が増えたときの伸び方です。1画面あたり22本の余分なクエリは、10件を50件にすれば110本になり、同時に100人が見れば1万本を超えます。本数はコードを見れば分かり、ミリ秒は本番の負荷でしか分からないので、まず本数で判断するほうが早い、というのが今回の実感でした。
2-2. 必要なカラムだけ取る
SELECT * は楽ですが、TEXT/JSON カラムや BLOB が混ざるとあっという間にデータ転送量が増えます。使うカラムだけ列挙 するだけで、レスポンスがガクンと速くなることがあります。
2-3. インデックスを EXPLAIN で確認する
遅いクエリは必ず EXPLAIN(PostgreSQL なら EXPLAIN ANALYZE)で実行計画を確認します。
- Seq Scan / Full Table Scan が見えたら、インデックスが効いていないサイン
- WHERE 句の左辺を関数で包んでいる(例:
WHERE LOWER(email) = ?)とインデックスが使われない - 複合インデックスは カラムの並び順 が重要(先頭カラムでフィルタしないと効かない)
2-4. ページネーションは OFFSET より cursor で
大量データで LIMIT 20 OFFSET 100000 のような書き方は、内部で 100,020 行を読んで先頭 100,000 行を捨てる動きをします。
無限スクロールのような UX なら、カーソル方式(WHERE id < ? ORDER BY id DESC LIMIT 20)に切り替えると、ページが深くなっても速度が落ちません。
3. キャッシュ戦略
クエリを速くするのが王道ですが、それでも足りない・そもそも計算結果を毎回作る必要がないものは キャッシュ で解決します。
- CDN キャッシュ(CloudFront / Cloudflare)
画像・CSS・JS、それからキャッシュ可能な GET API は CDN で逃がす - アプリケーションキャッシュ(Redis / Memcached)
集計結果やマスタデータなど、計算コストが高く更新頻度が低いものを置く - DB レイヤのキャッシュ(クエリキャッシュ・マテリアライズドビュー)
重い集計を事前計算しておく
キャッシュを入れるときは TTL とキャッシュキー設計 をセットで考えるのがポイント。「気付いたら古いデータを返し続けていた」を防ぐため、無効化の仕組みも最初から設計しておきます。
このブログで確認してみた
キャッシュは「効いているつもり」がいちばん危ないので、種類ごとにヘッダを取ってみました。
$ curl -sI https://wadokon.com/            # HTML
(Cache-Control なし)
cf-cache-status: DYNAMIC

$ curl -sI https://wadokon.com/wp-content/.../style.css
cache-control: max-age=604800
cf-cache-status: HIT
age: 297670結果は上の画像の下半分のとおりです。CSS・JS・画像は7日間キャッシュされてエッジにヒットしていて、実際に3〜4日前のものが返っていました(age が 266,000〜356,000秒)。ここは意図どおりです。
問題は HTML でした。Cache-Control が付いておらず、cf-cache-status: DYNAMIC。つまり毎回 PHP が動いています。 記事はほとんど更新しないので、本来はここがいちばんキャッシュの効くところです。
静的ファイルのキャッシュは何もしなくても効いていて、効かせたいところだけ効いていなかったわけです。「CDNを入れた=速くなった」で終わらせず、種類ごとに1回ずつ curl -I を打つ価値はあります。
4. 不要なリソースを削除する
パフォーマンス改善というと「速くする」イメージが強いですが、「使っていないものを止める / 消す」 ことで実質的に高速化&コスト削減ができるケースも多いです。
4-1. 起動しっぱなしのインスタンスを止める
検証用に立てたまま忘れている EC2 / RDS / ElastiCache、止め忘れた踏み台、テスト用 ECS タスク…。タグでオーナーと用途を必須化 し、定期棚卸しでオーナー不明のリソースは止める運用にすると、コストもパフォーマンスも自然に整います。
4-2. 使われていないテーブル・カラム・インデックス
使われていないインデックスは、書き込みコストを増やすだけのお荷物になります。PostgreSQL なら pg_stat_user_indexes、MySQL なら sys.schema_unused_indexes から 「一度も使われていないインデックス」 を抽出して定期的に整理します。
4-3. ログ・古いデータの保持期間を見直す
CloudWatch Logs、アプリログ、監査ログ、無限に伸びるテーブル…。保持期間を明確に決めて自動削除 するだけで、ストレージ I/O とコストの両方が軽くなります。
5. 改善を継続的に回す仕組み
パフォーマンスは「一度直して終わり」にはなりません。コード追加・データ増加でいつでも悪化します。
- 主要 API の p95 レイテンシをダッシュボード化 し、閾値超えでアラート
- リリース前後の 負荷テスト / ベンチマークを CI に組み込む
- スロークエリは Slack 通知するなど、変化に気付ける導線を作る
「重くなったら直す」ではなく 「重くなりかけたら気付ける」 仕組みを先に整えておくと、本番でユーザーから指摘される前に対処できます。
まとめ
パフォーマンス改善は、いきなり「スケールアップで解決」に走ると無駄なコストと労力を払いがちです。以下の順で見ていくと、費用対効果が高いポイントから着手できます。
- まず計測して、ボトルネックを事実ベースで特定する
- SQL クエリを最適化する(N+1、インデックス、必要カラムだけ)
- 足りない分はキャッシュで逃がす
- 不要なリソースは削る(インスタンス・インデックス・古いデータ)
- 継続的に監視できる仕組みを作る
実際にこのブログで測ってみて分かったのは、次の3点です。
- クエリ本数は数行で測れる
ただし計測前にキャッシュを空にしないと、少なく出る - N+1 の差は本数に出て、時間には出にくい
小さいDBでは 4.0 ms と 1.9 ms の差にしかならない。判断は本数でする - キャッシュは「効いていない場所」を探すために測る
静的ファイルは放っておいても効くので、確認すべきは HTML のほう
ガイドとして「まず計測から」と書くのは簡単ですが、実際に自分の環境に当ててみると、見えていなかったものが出てきます。今回の HTML のキャッシュがまさにそれでした。
「速いアプリ」は良いコードと良いインフラの両方から生まれます。次回以降は、それぞれをさらに深掘りした記事も書いていく予定です。
次に読む記事