重い処理をジョブキューに逃がすと、レスポンスは速くなります。ただ同期処理では起きなかった問題が、まとめて出てきます。同じ処理が2回走る、失敗したまま誰も気づかない、といったものです。
この記事では、リトライ・冪等性・デッドレターキューを実際に動かして確かめます。以下の出力はすべて実行結果です。
「少なくとも1回」の意味
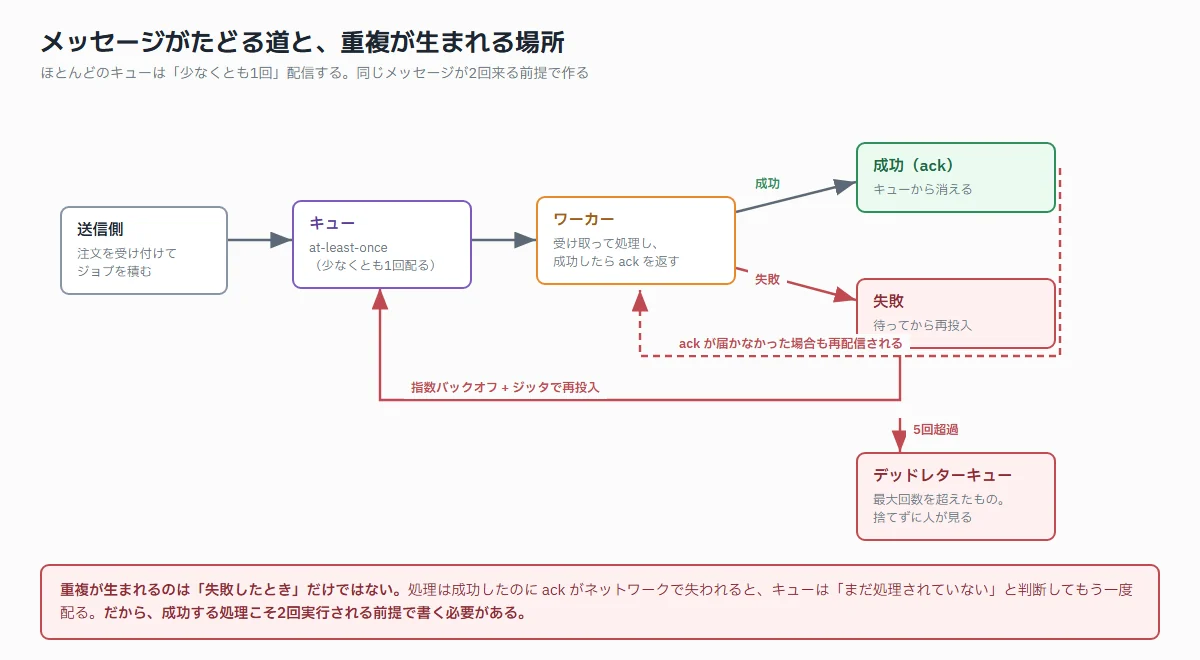
実務で使うキューのほとんどは at-least-once(少なくとも1回)配信です。1回しか配らないことを保証しません。これは実装の手抜きではなく、分散システムでは避けられない性質です。
重複が生まれるのは、失敗したときだけではありません。
- ワーカーが処理に成功した直後、ack を返す前に落ちた
- ack は送ったが、ネットワークの問題でキューに届かなかった
- 処理に時間がかかりすぎて、キュー側の可視性タイムアウトが切れた
どれも処理そのものは成功しています。それでもキューからは「まだ処理されていない」ように見えるので、もう一度配られます。
3つ目は特に見落とされがちです。ワーカーの処理が重くなってタイムアウトを超えると、1つ目がまだ動いている最中に2つ目が配られます。同時に2つ走る状態になります。
冪等性がないとどうなるか
同じメッセージが2回届いたときに、何が起きるかを実際に動かしました。3,000円の課金処理です。
function handleNaive(msg) {
  charge(msg.orderId, msg.amount);
}
=== 冪等キーなしで、同じメッセージが2回届いた ===
台帳: [{"orderId":"A-1001","amount":3000},{"orderId":"A-1001","amount":3000}]
合計: 6000 円当然ですが、2回課金されます。コードにバグはありません。「1回しか呼ばれない」という前提だけが間違っています。
冪等キーで止める
function handleIdempotent(msg) {
  if (processed.has(msg.idempotencyKey)) return "skipped";   // 2回目以降は何もしない
  charge(msg.orderId, msg.amount);
  processed.add(msg.idempotencyKey);
  return "charged";
}
=== 冪等キーありで、同じメッセージが2回届いた ===
1回目: charged
2回目: skipped
台帳: [{"orderId":"A-1001","amount":3000}]
合計: 3000 円設計のポイントはキーの作り方です。
- 送信側が決める
ワーカー側で生成すると、再配信のたびに違うキーになって意味がありません - 業務的に一意な値から作る
この例では注文ID + 操作名。ランダムなIDを毎回振ると、再送のたびに別物になります - 操作ごとに分ける
同じ注文でも「課金」と「メール送信」は別のキーにします
そして記録はメモリではなく、副作用と同じデータストアに置きます。上の例はメモリのSetですが、実際にはワーカーが複数台あり、再起動もします。理想は、課金の記録と冪等キーの記録を同じトランザクションで書くことです。別々だと「課金はしたがキーの記録に失敗した」という状態が生まれます。
データベースを使うなら、冪等キーにユニーク制約を張るのがいちばん確実です。二重挿入は制約違反で弾かれるので、アプリ側で「存在確認してから挿入」を書く必要がなくなります。確認と挿入の間に別プロセスが割り込む余地も消えます。
リトライの待ち方
失敗したらすぐ再試行する、という実装はよくありませんが、その理由は相手が落ちているときに追い打ちをかけるからです。復旧しかけたところに全ワーカーが一斉にリクエストを送れば、また落ちます。
そこで待ち時間を指数的に伸ばします。ただしそれだけでは足りません。同じタイミングで失敗した100件は、同じ計算式なら同じタイミングで再試行するからです。
そこにランダムを混ぜます(ジッタ)。実際に計算させた結果です。
const exp = Math.min(cap, base * 2 ** (attempt - 1));
const wait = Math.round(Math.random() * exp);      // full jitter
1回目: 上限 1000ms → 実際に待つ 89ms
2回目: 上限 2000ms → 実際に待つ 1690ms
3回目: 上限 4000ms → 実際に待つ 1492ms
4回目: 上限 8000ms → 実際に待つ 5ms
5回目: 上限 16000ms → 実際に待つ 9880ms
6回目: 上限 32000ms → 実際に待つ 4237ms
7回目: 上限 60000ms → 実際に待つ 43053ms待ち時間がばらけているのが分かります。上限だけが指数的に伸びて、実際の待ち時間はその範囲でランダムになります。これで再試行が一点に集中しなくなります。
上限(ここでは60秒)を設けるのも重要です。指数のまま伸ばすと、10回目には十数分待つことになります。
リトライしてはいけない失敗がある
ここは実装で間違えやすいところです。何度やっても結果が変わらない失敗を、5回繰り返す意味はありません。
| 失敗の種類 | 例 | リトライ |
|---|---|---|
| 一時的なもの | タイムアウト、503、接続断、429 | する |
| 入力が悪いもの | 400、422、必須項目の欠落 | しない |
| 権限がないもの | 401、403 | しない |
| 対象がないもの | 404 | しない |
リトライしない種類のものは、即座にデッドレターへ送るのが正しい扱いです。5回失敗するのを待つと、原因の把握が5倍遅れます。
デッドレターキューは「捨て場」ではない
=== 5回失敗したらデッドレターへ ===
  試行 1/5 … 失敗
  試行 2/5 … 失敗
  試行 3/5 … 失敗
  試行 4/5 … 失敗
  試行 5/5 … 失敗
  デッドレター: [{"orderId":"A-1001","amount":3000,
                 "idempotencyKey":"A-1001:charge",
"attempts":5,"lastError":"downstream_timeout"}]デッドレターキューがないと、失敗したメッセージは永久にリトライされ続けるか、黙って消えます。どちらも困ります。前者はリソースを食い続け、後者は「注文が処理されていない」ことに誰も気づきません。
運用するうえで必要なのは3つです。
- 入ったら通知する
DLQは放っておくと誰も見ません。1件でも入ったらアラートを出します - 原因が分かる情報を一緒に入れる
メッセージ本体だけでなく、試行回数・最後のエラー・リクエストIDを添えます - 直したあとに再投入できるようにする
DLQから元のキューへ戻す操作を用意しておきます
再投入するときに効いてくるのが冪等性です。「途中まで処理されていたかもしれない」メッセージを安全に流し直せるのは、冪等に作ってあるからです。ここが繋がっていないと、DLQからの再投入自体が怖くてできません。
メッセージに何を入れるか
意外と迷うのがここです。「注文が確定した」というジョブを積むとき、注文の中身を全部入れるのか、注文IDだけ入れるのか。
| データを全部入れる | IDだけ入れる | |
|---|---|---|
| ワーカー側 | DBを読まなくていい | 毎回DBを読む |
| 読むデータ | 積んだ時点のもの | 処理する時点の最新 |
| メッセージサイズ | 大きい(上限に当たることがある) | 小さい |
| リトライ時 | 古いデータのまま再実行される | 最新で再実行される |
基本はIDだけを入れるほうが安全です。理由は3行目と4行目で、リトライが数分後に走ったとき、その間にデータが変わっている可能性があるからです。注文がキャンセルされているのに、古い内容で発送処理が走る、というのが典型的な事故です。
ただしIDだけにすると、ワーカーが処理する時点でレコードが消えていることがあります。この場合は「対象がない」という失敗なので、リトライせずに正常終了として扱うのが妥当です。前述の表でいう「リトライしない失敗」です。
データを入れるとしても、後から変わらないもの(金額の確定値、その時点のスナップショット)に限ると決めておくと判断がぶれません。
可視性タイムアウトを処理時間より長くする
もう1つ、設定として必ず確認したいのがこれです。ワーカーがメッセージを受け取ってから ack を返すまでの猶予時間で、これを超えると「そのワーカーは死んだ」と判断されて別のワーカーに配られます。
処理時間より短く設定されていると、1つ目がまだ動いている最中に2つ目が走ります。しかも処理が重くなるほど発生しやすくなるので、データが増えてから顕在化します。
- 実測した処理時間の数倍を設定する
- 長時間かかる処理は、途中で猶予を延長できる仕組みがあればそれを使う
- そもそも1メッセージあたりの処理を小さく分割するのがいちばん効く
定期実行も同じ問題を持つ
キューだけの話ではありません。cron のような定期実行にも同じ性質があります。
このブログは、週次のアクセスレポートを Cloudflare Workers の cron で動かして、結果をNotionに投稿しています。ここで「同じ週のレポートが2回投稿される」ことは十分に起こりえます。実行環境の再試行、デプロイのタイミング、手動実行の重なりなど、理由はいくらでもあります。
防ぎ方は同じで、「対象週」を冪等キーにします。投稿前にその週のページが既にあるかを確認し、あれば更新するか何もしない。2026-W36 のような値を1つ持つだけで、重複投稿は構造的に起きなくなります。
非同期処理の設計は「1回だけ実行されること」を保証しようとすると難しくなり、「何回実行されても同じ結果になること」を目指すと簡単になります。この置き換えが、この分野でいちばん大きい考え方の転換だと思います。
まとめ
- キューは「少なくとも1回」
成功した処理も再配信されうる - 冪等キーは送信側が、業務的に一意な値から作る
ワーカー側で作ると意味がない - キーの記録は副作用と同じトランザクションで
ユニーク制約に任せるのが確実 - バックオフにはジッタを混ぜる
指数だけだと再試行が一点に集中する - リトライしても無駄な失敗は即DLQへ
400番台を5回試さない - DLQは通知と再投入までがセット
入れっぱなしなら消しているのと同じ - cron も同じ
「1回だけ」ではなく「何回でも同じ結果」を目指す
次に読む記事