インデックスは「検索に使う列に付ける」で済む話ではありません。複合インデックスは列の順番を間違えると、付けているのに遅いという状態になります。
この記事では、MySQL 8.0.35 に50万行のテーブルを作り、クエリを変えずにインデックスだけを差し替えて実測しました。以下の数字と EXPLAIN の出力はすべて実行結果です。
検証環境
CREATE TABLE orders (
  id            BIGINT AUTO_INCREMENT PRIMARY KEY,
  shop_id       INT          NOT NULL,   -- 50店舗
  status        VARCHAR(16)  NOT NULL,   -- paid 90% / pending 7% / canceled 3%
  created_at    DATETIME     NOT NULL,   -- 2年分に分散
  total         INT          NOT NULL,
  customer_name VARCHAR(64)  NOT NULL
) ENGINE=InnoDB;
-- 500,000行
試すのは、業務システムでいちばんよく書くタイプのクエリです。
SELECT id, total FROM orders
 WHERE shop_id = 7
   AND created_at >= '2025-06-01' AND created_at < '2025-07-01';
-- 該当するのは 420 行
50万行のうち420行だけを取り出す、選択性の高いクエリです。
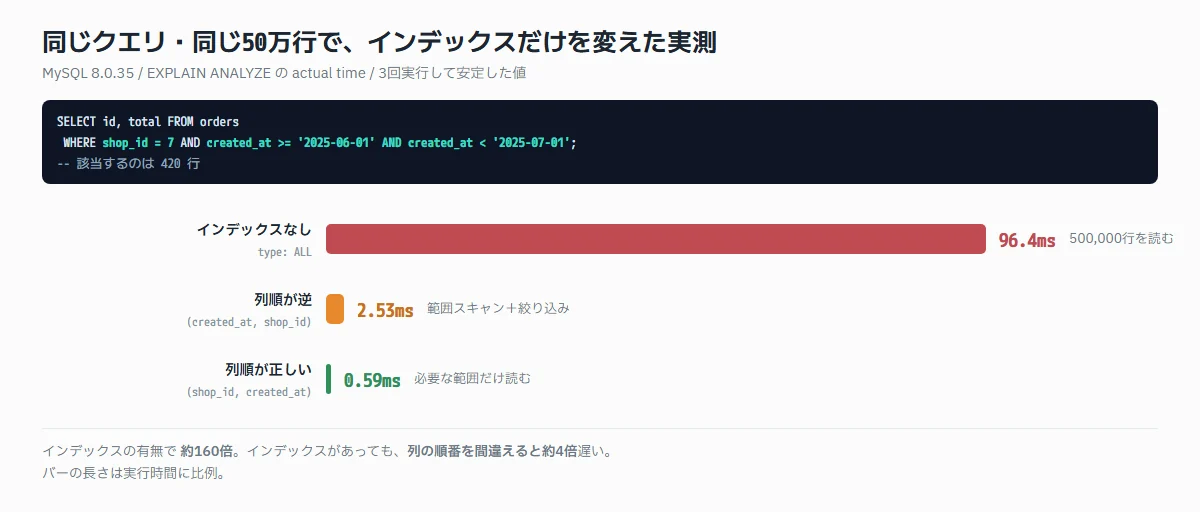
1) インデックスなし
         type: ALL
possible_keys: NULL
          key: NULL
         rows: 498207
        Extra: Using where

-> Table scan on orders (actual time=0.0458..81.4 rows=500000 loops=1)
   実行時間 96.4ms
type: ALL が全表スキャンの印です。420行を取り出すために50万行を全部読んでいます。
EXPLAIN でまず見るべきなのは、この type と rows の2つです。
| type | 意味 | 評価 |
|---|---|---|
ALL | 全表スキャン | 大きいテーブルでは危険 |
index | インデックス全体のスキャン | ALLよりましだが全件読んでいる |
range | インデックスの範囲スキャン | 良い |
ref | 等値での参照 | 良い |
const / eq_ref | 1行に確定 | 最良 |
rows は「読むと見積もった行数」です。実際に返る行数と桁が違うなら、そのぶん無駄に読んでいます。ここでは 498,207 対 420 なので、1000倍以上の無駄があります。
2) 列順を間違えた複合インデックス
CREATE INDEX idx_created_shop ON orders (created_at, shop_id); type: range
key: idx_created_shop
filtered: 5.00
Extra: Using index condition
-> Index range scan over ('2025-06-01' <= created_at <= '2025-07-01'
AND 7 <= shop_id)
実行時間 2.53ms96.4msから2.53msになりました。これだけ見れば「速くなった、解決」と判断してしまいます。しかしスキャンの範囲を見てください。
over ('2025-06-01' <= created_at <= '2025-07-01' AND 7 <= shop_id)shop_id = 7 ではなく 7 <= shop_id になっています。等値で指定したはずの条件が、範囲条件として扱われています。
そして filtered: 5.00。これは「インデックスで絞ったあと、さらに5%まで絞られる」という意味で、インデックスで絞りきれていないことを示しています。
3) 列順を直す
CREATE INDEX idx_shop_created ON orders (shop_id, created_at); type: range
key: idx_shop_created
filtered: 100.00
Extra: Using index condition
-> Index range scan over (shop_id = 7
AND '2025-06-01' <= created_at < '2025-07-01')
実行時間 0.59msshop_id = 7 と等値で入り、filtered が100%になりました。インデックスだけで必要な範囲が確定している状態です。2.53msから0.59msへ、さらに4倍以上速くなりました。
なぜ順番でこうなるのか
複合インデックスは電話帳と同じです。「姓、名」の順で並んでいる電話帳では、姓を決めれば名を効率的に探せます。しかし「名」だけを指定して探すことはできません。
ここから導かれるルールが1つあります。
範囲条件(> < BETWEEN LIKE 'x%')を使う列より後ろの列は、絞り込みに使えない。
(created_at, shop_id) では、先頭の created_at が範囲条件なので、その時点でインデックスの並びが「1か月分の全店舗」に散らばります。後ろの shop_id はもう順番の役に立ちません。
したがって列順の原則はこうなります。
- 等値条件で使う列を先に(
=やIN) - 範囲条件で使う列を後ろに
- その中では、絞り込みが効く(値の種類が多い)列を先に
4) 3列以上でも同じ
条件が3つになっても考え方は変わりません。
WHERE shop_id = 7 AND status = 'pending'
AND created_at >= '2025-06-01' AND created_at < '2025-07-01'| インデックス | filtered | 状態 |
|---|---|---|
| (shop_id, created_at, status) | 50.00 | 範囲の後ろの status を絞り込みに使えない |
| (shop_id, status, created_at) | 100.00 | 等値2つを先に置けている |
等値の status を範囲の created_at より前に置くのが正解です。「条件に書いた順」でも「テーブル定義の順」でもなく、等値が先、範囲が後で決まります。
5) 値の種類が少ない列は単独では効かない
status だけにインデックスを張って、値ごとに EXPLAIN を取りました。
| クエリ | データ比率 | rows(読む見積もり) |
|---|---|---|
status = 'paid' | 90% | 249,205 |
status = 'canceled' | 3% | 29,840 |
同じインデックス、同じ列でも、指定する値によって読む量が8倍違います。90%が該当する paid では、インデックスをたどってから大量の行を読むので、全表スキャンとほとんど変わりません。
ここから2つのことが言えます。
- 値の種類が少ない列に単独でインデックスを張っても効かない
フラグ列や区分値の単独インデックスはほぼ無駄で、更新のコストだけがかかります - 効くかどうかは「実際にどの値で検索されるか」による
開発環境の少量データでは判断できません
こういう列は、単独ではなく選択性の高い列と組み合わせた複合インデックスの一部として使います。
6) 列を関数で包むと全部台無しになる
これがいちばん差が出ました。「その日の注文を取る」を2通りで書いて比べます。
-- A: 列を関数で包む
WHERE DATE(created_at) = '2025-06-15'
   -> Filter: (cast(created_at as date) = '2025-06-15')
      (actual time=96.2..134 rows=625)     500,000行を読む

-- B: 範囲で書く
WHERE created_at >= '2025-06-15' AND created_at < '2025-06-16'
   -> Covering index range scan
      (actual time=0.0136..0.238 rows=625)   625行だけ読む
134ms と 0.238ms。約560倍の差です。返る行数はどちらも625行で同じです。
インデックスに入っているのは created_at の値であって、DATE(created_at) の値ではありません。列を加工した瞬間、インデックスの並び順は使えなくなります。全行に関数を適用して比較するしかなくなります。
同じ理由で、次のような書き方も効きません。
WHERE YEAR(created_at) = 2025→ 範囲で書くWHERE CONCAT(a, b) = '...'→ 分けて書くWHERE price * 1.1 > 1000→price > 1000 / 1.1と書くWHERE name LIKE '%田中%'→ 前方一致でないと使えない- 暗黙の型変換
varcharの列に数値を渡すと、内部で変換が入って同じことが起きる
最後の型変換は特に気づきにくいところです。EXPLAIN で type: ALL が出たのに原因が分からないときは、比較している値の型が一致しているかを確認してみてください。
7) カバリングインデックス
Extra に Using index と出ることがあります。これはインデックスだけで完結し、テーブル本体を読んでいないという意味です。
SELECT shop_id, created_at FROM orders
 WHERE shop_id = 7 AND created_at >= '2025-06-01' AND created_at < '2025-07-01';

Extra: Using where; Using index取得する列がすべてインデックスに含まれていれば、テーブルを引きにいく手間が丸ごと消えます。SELECT * をやめるだけで、この状態になることがあります。
紛らわしいのですが、Using index(カバリング=良い)と Using index condition(絞り込みをインデックス側で行う=これも良い)と Using where(読んだあとに絞る)は別物です。type: index(インデックス全体のスキャン=良くない)とも混同しないでください。
インデックスを増やすコスト
ここまで「付ければ速い」という話をしてきましたが、無条件ではありません。
- INSERT / UPDATE / DELETE が遅くなる
インデックスの数だけ更新が必要です - ディスクとメモリを食う
インデックスもキャッシュに乗る領域を奪い合います - オプティマイザが迷う
似たインデックスが並ぶと、選択を誤ることがあります
特に多いのが先頭列が重複したインデックスです。(shop_id) と (shop_id, created_at) が両方あるなら、前者は後者に含まれるので不要です。(shop_id, created_at) は shop_id 単独の検索にもそのまま使えます。
まとめ
- 列順は「等値が先、範囲が後」
順番を間違えると、付いていても4倍遅かった - 範囲条件より後ろの列は絞り込みに使えない
これが列順を決める唯一の理由 EXPLAINはtypeとrowsから読む
返る行数と桁が違えば無駄があるfilteredを見る
100%でなければインデックスで絞りきれていない- 値の種類が少ない列の単独インデックスは効かない
値によって8倍差が出た - 列を関数で包まない
今回は560倍の差になった - 速くなったで止めない
96ms→2.5msで満足していたら、0.59msには届かなかった
最後の点が実務ではいちばん効くと思います。改善したかどうかではなく、まだ無駄が残っていないかを EXPLAIN で確認するのが、この作業の本体です。
次に読む記事