日本語のWebフォントは重い、というのはよく言われます。ただ「Google Fontsは unicode-range で分割していて、そのページに出てくる文字が含まれるファイルだけを読み込むから効率的」という説明もセットで出てきます。
本当にそうなのか、自分のブログで測ってみました。結果は、ページの内容がまったく違っても、読み込まれるフォントは1バイトも変わりませんでした。
4ページ測った結果
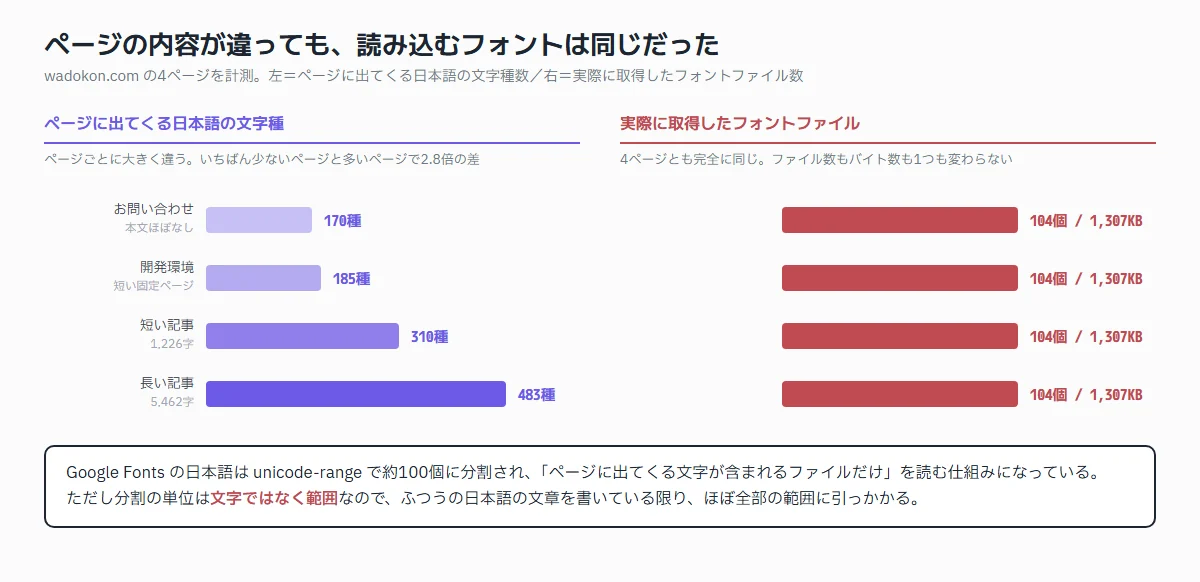
本文がほとんどないお問い合わせページから、5,462字の長い記事まで、性質の違う4ページを選びました。それぞれ、ページに出てくる日本語の文字の種類と、ブラウザが実際に取得したフォントファイルを数えます。
| ページ | 日本語の文字種 | フォントファイル | 転送量 |
|---|---|---|---|
| お問い合わせ(本文ほぼなし) | 170種 | 104個 | 1,307 KB |
| 開発環境(短い固定ページ) | 185種 | 104個 | 1,307 KB |
| 短い記事(1,226字) | 310種 | 104個 | 1,307 KB |
| 長い記事(5,462字) | 483種 | 104個 | 1,307 KB |
文字の種類は2.8倍の差があります。文字種の差でいうと、長い記事にはお問い合わせページに出てこない文字が324種、実に67%も含まれています。それでも取得したファイルは104個、1,307KBで完全に同一でした。
計測はブラウザの Resource Timing API で、ページを開いて読み込みが落ち着いてから数えています。
const f = performance.getEntriesByType('resource')
  .filter(x => x.name.includes('fonts.gstatic.com'));

({ files: f.length,
   kb: Math.round(f.reduce((s, x) => s + (x.encodedBodySize || 0), 0) / 1024) })
なぜ変わらないのか
理由は2つあります。
分割の単位が「文字」ではなく「範囲」だから
Google Fonts の日本語フォントは、CSSの中で unicode-range によって約100個のファイルに分けられています。イメージとしてはこうです。
@font-face {
  font-family: 'IBM Plex Sans JP';
  src: url(...119.woff2) format('woff2');
  unicode-range: U+xxxx-xxxx, U+xxxx, ... ;   /* この範囲に1文字でも該当すれば取得 */
}
ブラウザは、ページに出てくる文字が unicode-range に1つでも該当すれば、そのファイルを丸ごと取得します。数百文字の日本語を書けば、その文字は当然コードポイント空間の広い範囲に散らばります。結果として、ほぼ全部の分割ファイルに引っかかります。
つまりこの最適化が効くのは「使う文字が極端に少ないとき」だけです。ロゴやキャッチコピーに数十文字だけ使うなら効きますが、日本語の文章を載せるページでは、ほぼ機能しません。
サイト共通の部分にも日本語があるから
もう1つは、ページ本文だけを見ていると見落とす点です。ヘッダーのメニュー、サイドバーの記事一覧、カテゴリ一覧、フッター。これらはどのページにも同じように出てきます。
実際に測ると、この4ページすべてに共通して出てくる文字が136種ありました。お問い合わせページの170種のうち、8割がサイト共通の部分から来ていることになります。本文を空にしても、日本語フォントの読み込みはほとんど減りません。
では、どうするか
「unicode-range が効くから大丈夫」という前提が崩れると、対策は別のものになります。効果の大きい順に並べます。
| 方法 | 効果 | コスト |
|---|---|---|
| 本文をシステムフォントにする | 大(本文用フォントの分がまるごと消える) | 読み味が変わる |
| 見出し用フォントをやめる | 大(見出し用も数百KBある) | 印象が変わる |
| サブセット化してセルフホスト | 大 | ビルド工程と、文字欠けの管理 |
| ウェイトを減らす | 中(1ウェイトごとに一式増える) | ほぼなし。まずやるべき |
font-display: swap | 小(体感のみ) | ほぼなし |
まずウェイトを見直す
コストがほぼゼロで効くのがこれです。wght@400;500;700 と3つ指定していれば、約100個の分割ファイルが3セット、つまり300個分読み込まれる可能性があります。
実際に500を使っている箇所がどれだけあるかを確認して、使っていないウェイトを外すだけで、素直に3分の1ずつ減ります。「一応入れておいた」ウェイトは、日本語では一番高くつきます。
font-display: swap は軽くしない
誤解されやすいのがこれです。font-display: swap は読み込み量を1バイトも減らしません。やっているのは「フォントが届くまで代替フォントで表示しておく」ことだけです。
文字が見えない時間(FOIT)はなくなりますが、代わりにフォントが届いた瞬間に字形が入れ替わります(FOUT)。代替フォントと本命フォントの字幅が違えば、そこでレイアウトがずれます。
減らす対策と、見え方を整える対策は別ものだ、と切り分けて考える必要があります。
システムフォントという選択
いちばん効くのは、結局これです。転送量はゼロになります。
body {
  font-family:
    system-ui,
    -apple-system,
    "Hiragino Kaku Gothic ProN",  /* macOS / iOS */
    "Yu Gothic UI", "Meiryo",     /* Windows */
    "Noto Sans JP",               /* Android など */
    sans-serif;
}欠点もはっきりしていて、環境ごとに見え方が変わります。デザインの再現性を優先するならWebフォントですし、速度を優先するならシステムフォントです。ここは技術的な正解ではなく、サイトとして何を優先するかの判断になります。
判断材料としては、「そのフォントでなければ成立しないのか」を自問するのが早いと思います。ブランドの一部になっているなら残す価値がありますし、なんとなく良さそうで選んだなら、数百KBの価値はないかもしれません。
サイズと行間を実測する
フォントの重さとは別に、読みやすさの話もしておきます。このブログの実際の描画値を、ブラウザから取りました(ビューポート1280px)。
| 要素 | フォントサイズ | 行の高さ | 比率 | 1行の文字数 |
|---|---|---|---|---|
| 本文 | 16px | 32px | 2.00 | 約49文字 |
| h2 | 22.4px | 31.4px | 1.40 | — |
| h3 | 20.8px | 29.1px | 1.40 | — |
| コード | 14px | 25.2px | 1.80 | — |
行間は英語より広く要る
本文の比率2.0は、英語圏の一般的な推奨(1.5前後)より明らかに広い値です。これは日本語の性質によるものです。
- 漢字は画数が多く、字面が詰まって見える
行間が狭いと上下の行と混ざります - 日本語には単語間のスペースがない
行の切れ目が視覚的な手がかりになるため、行の区別がつくことが重要です - アルファベットのような上下の突き出しが少ない
行の輪郭が平坦なので、間隔で区切る必要があります
日本語の本文では 1.7〜2.0 あたりが実用的な範囲です。逆に見出しは文字が大きく、1〜2行で終わるので、1.3〜1.4程度に詰めたほうが塊として見えます。本文と見出しで同じ行間を使わないのがポイントです。
1行49文字は少し長い
測ってみて気になったのがここです。本文の幅が781pxで16pxなので、1行あたり約49文字入ります。
日本語の読みやすい行長は35〜45文字程度とされます。行が長いと、行末から次の行頭に視線を戻すときに、目的の行を見失いやすくなるためです。49文字はその上限を少し超えています。
対策は本文幅に上限を設けることです。max-width を em で指定すると、フォントサイズが変わっても文字数が保たれます。
.post_content p {
  max-width: 42em;   /* 全角なら約42文字。em なので文字数基準になる */
}ここは実際に直すかどうか迷っている部分です。数字の上では長めですが、行間を2.0と広く取っているぶん、行を見失いにくくはなっています。数値と実際の読み心地は必ずしも一致しないので、変えるなら実際に読み比べてから決めるつもりです。
見出しは「大きい文字」ではない
もう1つ、測って気づいたことがあります。h2 は 22.4px です。感覚的には十分大きいのですが、アクセシビリティの基準でいう「大きい文字」(24px以上)には届いていません。
つまり見出しの色は、緩い基準(3:1)ではなく本文と同じ基準(4.5:1)で見る必要があります。この話は配色を実測した記事に詳しく書きました。タイポグラフィと配色は、こういうところでつながっています。
まとめ
- 日本語の unicode-range 分割は、文章を載せるページではほぼ効かない
4ページ測って1バイトも変わらなかった - 本文を空にしても減らない
ヘッダーやサイドバーの日本語が効いている - まずウェイトを減らす
コストがほぼゼロで、1ウェイトごとに一式減る font-display: swapは軽くしない
見え方の対策であって、量の対策ではない- 日本語の行間は1.7〜2.0、行長は35〜45文字
見出しは行間を詰める - 思い込みではなく測る
「効率的なはず」の仕組みが効いていないことがある
次に読む記事